 أنور پآي
الفيديو يقدم مقدمة عربية قصيرة للفكرة. عند نشر المقال، يظهر الرابط المنفرد كمشغّل YouTube لا يُحمَّل إلا بعد الضغط، ويمكنك فتح الفيديو على YouTube أيضًا. [8]
هل تحتاج إلى كرت شاشة كي تتعلم توليد الصور بالذكاء الاصطناعي؟ يقدم AuroraIMG-6M نموذجًا صغيرًا يمكن تشغيله على المعالج، ويجمع مكوناته كلها في نحو 6.82 ملايين معامل. المقابل واضح: صور صغيرة بدقة 64×64، وأوصاف إنجليزية قصيرة، وقدرات محدودة على التفاصيل والمشاهد المعقدة. [1]
هذا المقال يجمع شرح النموذج والفيديو المرفق في مكان واحد. راجعنا بطاقة النموذج وملفات إعداداته وشيفرته؛ لم ننزّل الأوزان أو نشغّل توليدًا فعليًا لإعداد المقال. الأمثلة المصوّرة من الناشر، وأرقام التقييم نتائجه المعلنة، وليست اختبارات نفذها فريق أنور پآي.
لمن هذا؟
لمن يريد فهم كيف يتحول وصف قصير إلى صورة، أو تجربة نموذج صغير على جهاز محدود، أو قراءة مشروع تعليمي يمكن تتبّع أجزائه. إذا كنت تتوقع صورًا واقعية كبيرة، أو نصوصًا واضحة داخل الصور، أو تحكمًا دقيقًا في عدد الأشياء ومواقعها، فهذا ليس النموذج المناسب لهذه المهمة.
النموذج يحول النص إلى صورة عبر ثلاثة أجزاء: مشفّر النص يحوّل الكلمات إلى تمثيل رقمي، ومزيل الضجيج يعمل تدريجيًا على تكوين المشهد، وVAE يحوّل التمثيل المضغوط للصورة إلى وحدات بكسل تراها. الفكرة المهمة هنا أن العدد المعلن يشمل الأجزاء الثلاثة، وليس الجزء الذي يولّد الصورة وحده. [1][2]
وفق تقرير المشروع، العدد الكلي هو 6,822,747 معاملًا. والمعاملات هي القيم الرقمية التي يتعلمها النموذج أثناء التدريب؛ عددها لا يساوي وحده حجم ذاكرة التشغيل أو سرعة إنجاز الصورة. يقول الناشر إن المكونات دُرّبت من الصفر، دون مشفّر نص أو VAE مُدرّب مسبقًا، على نحو 9.88 ملايين زوج من الصور والأوصاف من CC12M. [1][2]
لا نصفه بأنه «بديل للنماذج الكبيرة بالجودة نفسها». قيمته للمبتدئ أن التجربة محدودة وواضحة: وصف بسيط، وصورة صغيرة، ثم مقارنة ما طلبته بما ظهر فعلًا.
ماذا ستحتاج؟
جهازًا يستطيع تشغيل Python ومكتبات النموذج. توثيق المشروع يوفر مسار CPU، أي المعالج الرئيسي؛ كرت NVIDIA ليس شرطًا لهذا المسار. لم نقس زمن التوليد أو الاستهلاك على جهاز معين، ولا نَعِد بأنه سريع أو مناسب لكل جهاز قديم.
Python وبيئة منفصلة للتجربة، ومكتبات PyTorch وDiffusers وTransformers وSafetensors. ملفات النموذج تشير إلى Diffusers 0.40.0؛ هذه إشارة إلى نسخة إعداد الناشر، وليست اختبار توافق أجريناه لكل مجموعة إصدارات. [3]
اتصالًا بالإنترنت لتنزيل المكتبات والأوزان أول مرة. صغر النموذج لا يجعل حزمة PyTorch وبقية الاعتماديات صغيرة بالقدر نفسه.
وصفًا إنجليزيًا قصيرًا، مثل a sunset over the ocean. بطاقة النموذج لا تعلن دعم العربية؛ وشيفرته تنظف النص وتحوّله إلى حروف صغيرة. [1][4]
استعدادًا لمراجعة شيفرة خارجية قبل تشغيلها. المثال يستخدم custom_pipeline وtrust_remote_code=True، أي أنه يحمّل شيفرة Python من مستودع النموذج، لا أوزانًا رقمية فقط. [5]
حدّ الأمان: جرّب في بيئة معزولة لا تحتوي مفاتيحك أو ملفاتك الخاصة. تثبيت مراجعة محددة للمصدر يقلل خطر تغيّر الشيفرة بعد مراجعتها، لكنه لا يثبت أمانها. وجود ملفات Safetensors لا يلغي الخطر الذي يأتي من تشغيل الشيفرة المخصصة. [5][6]
تُعلن بطاقة النموذج ترخيص Apache 2.0 للأوزان، مع تنبيه إلى أن صور بيانات التدريب تحمل تراخيصها الخاصة. لا نفترض أن ترخيص الأوزان يحسم حقوق بيانات التدريب أو كل استخدام ممكن للمخرجات. [1]
النتيجة النهائية (صورة)
النتيجة التي تستهدفها في أول تجربة هي ملف صورة بدقة 64×64 من عبارة قصيرة، لا صورة كبيرة للطباعة أو إعلان جاهز.
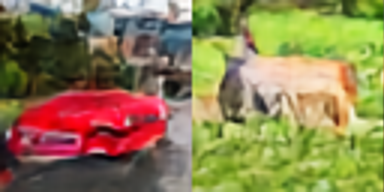
قصصنا مثالين من لوحة النتائج المنشورة، دون تحسين تفاصيلهما أو توليد بدائل لهما. يسهل تمييز الفكرة العامة، لكن التفاصيل ضعيفة. تكبير العرض لا يضيف معلومات جديدة إلى الصورة الأصلية. واللوحة التي أخذنا منها المقتطف موصوفة في البطاقة بأنها ناتج نقطة التدريب النهائية عند CFG 3؛ هذا مختلف عن إعداد CFG 6 الموصى به في مثال التشغيل. CFG قيمة تتحكم في شدة ارتباط التوليد بوصفك. [1][7]
توضيح مهم لرقم 88% الوارد في الشرح: لدى الناشر، درجة CLIP للصور المولّدة نحو 24.80، مقابل 28.25 للصور الحقيقية عند مقارنتها بأوصافها. النسبة بين الدرجتين نحو 88%؛ لا تعني أن الصور «واقعية بنسبة 88%» أو أن 88% من الطلبات نُفذت بصورة صحيحة. CLIP هنا مقياس للعلاقة بين الصورة والنص، وليس نسبة جودة شاملة. [2]
ولرؤية الحد الآخر، تعلن البطاقة نتيجة إجمالية 0.1387 على GenEval، وهو اختبار يراجع تنفيذ مهام مثل الألوان والعدّ والعلاقات بين الأشياء. وتبلغ نتيجة مهمة تحديد الموضع 0.75% في ذلك التقييم. هذه نتائج منشورة من المطوّر، لكنها توضح لماذا نبدأ بمشهد بسيط ولا نبني وعودًا كبيرة على حجم النموذج. [1]
خطوات 1-2-3
1. جهّز بيئة منفصلة وراجع المصدر
على Linux أو macOS، يمكنك إنشاء بيئة Python منفصلة بهذا الشكل:
python -m venv .venv
source .venv/bin/activate
وعلى Windows في PowerShell:
python -m venv .venv
.\.venv\Scripts\Activate.ps1
إذا منع Windows التفعيل بسياسة مؤسسية، لا تعطل السياسة كي تكمل المقال؛ اتبع إعداد المؤسسة أو استخدم طريقة تشغيل البيئة المسموح بها.
داخل البيئة، ثبّت الاعتماديات:
python -m pip install torch "diffusers==0.40.0" transformers safetensors
هذا إعداد مقترح مبني على imports الشيفرة ونسخة Diffusers المسجلة في المستودع، وليس سجل تثبيت اختبرناه. اختر حزمة PyTorch المناسبة لنظامك؛ وللمسار الأبسط هنا لا تحتاج إعداد CUDA لتشغيل CPU.
قبل تنفيذ المثال، اقرأ pipeline.py في مراجعة المصدر المرتبطة أدناه. يمكنك أيضًا مراجعة ملفات المكونات الموجودة تحت text_encoder وunet وvae. لا تغيّر trust_remote_code إلى True لمجرد التخلص من رسالة تحذير دون فهم ما ستشغّله. [4][5]
2. ابدأ بصورة واحدة ووصف قصير
المثال التالي مقتبس من طريقة التشغيل المنشورة، مع اختيار CPU وتثبيت مراجعة الأوزان والشيفرة التي راجعناها. تدعم وثائق Diffusers استخدام revision وcustom_revision لتحديد المصدر. لم ننفّذ هذا التوليد أثناء إعداد المقال. [1][5]
from diffusers import DiffusionPipeline
import torch

model_id = "AuroraAI-Research/AuroraIMG-6M"
revision = "3d66743c3139d034b832a670d067221f5d544bbb"

pipe = DiffusionPipeline.from_pretrained(
    model_id,
    custom_pipeline=model_id,
    revision=revision,
    custom_revision=revision,
    trust_remote_code=True,
    torch_dtype=torch.float32,
).to("cpu")

image = pipe(
    prompt="a sunset over the ocean",
    num_inference_steps=50,
    guidance_scale=6.0,
    generator=torch.Generator(device="cpu").manual_seed(42),
).images[0]

image.save("Aurora-Image.png")
إذا كان إعدادك متوافقًا، تكون النتيجة المتوقعة ملف Aurora-Image.png. استخدم وصفًا واحدًا أولًا، ولا تبدأ بجملة طويلة فيها عدة أشخاص وأشياء وعلاقات مكانية. الـSeed، أو البذرة، تحدد نقطة العشوائية الابتدائية؛ تثبيتها يساعدك على مقارنة التجارب في الإعداد نفسه، دون ضمان تطابق كل بيئة حوسبة.
3. افحص الصورة قبل توسيع التجربة
افتح الملف وتحقق من أبعاده، ثم قارن الصورة بالوصف: هل يظهر الموضوع الأساسي؟ هل البيئة مفهومة؟ هل أضاف النموذج شيئًا لم تطلبه؟
جرّب بعدها تغيير الوصف إلى عبارة قصيرة أخرى، مع إبقاء بقية الإعدادات ثابتة. يمكنك استخدام أوصاف الناشر مثل a red car on a street أو a snowy mountain with blue sky.
لا تعتبر الصورة الأكبر بعد التكبير دليلًا على تحسن النموذج. ولا تعتبر نجاح طلب واحد اختبارًا شاملًا. وإذا أردت قياس زمن التشغيل، سجّل جهازك ونسخ المكتبات والمدة التي استغرقها طلبك فعلًا، بدل استنتاج السرعة من عدد المعاملات.
مشاكل شائعة
الصور تبدو ضبابية أو التفاصيل غير واضحة. هذا متوقع من دقة 64×64. لا توجد هنا مساحة كافية لتفاصيل الوجوه واليدين والكتابة؛ اختر مهمة تعليمية مناسبة، أو نموذجًا أعلى دقة إذا كانت التفاصيل شرطًا. [1]
الوصف العربي أو الطويل يعطي نتيجة ضعيفة. البطاقة توصي بأوصاف إنجليزية قصيرة، بحروف صغيرة، وفي أسلوب وصف الصور. تذكر حدًا يصل إلى 62 رمزًا للوصف، رغم أن نافذة المشفّر الكلية تبلغ 64؛ وجود رقم 64 لا يعني إدخال 64 كلمة عربية. [1][4]
العدّ والألوان ومواقع الأشياء لا تطابق المطلوب. النتائج المنشورة على GenEval تسجل ضعفًا في هذه المهام. تقليل تعقيد الطلب قد يجعل التجربة أوضح، لكنه لا يضمن حل المشكلة؛ لا تستخدم النموذج حيث تكون الدقة شرطًا حاسمًا. [1]
تحميل الـpipeline أو tokenizer يفشل. النموذج يستخدم مكونات مخصصة، وتظهر TokenizersBackend في ملفات الإعداد. سجّل رسالة الخطأ ونسخ المكتبات، وراجع توافقها مع ملفات المصدر قبل تحديث كل شيء عشوائيًا. لا ندّعي هنا وجود خطأ بعينه أو إصلاح مجرّب له. [3]
التوليد على CPU أبطأ مما توقعت. قابلية التشغيل على المعالج لا تعني زمنًا ثابتًا أو أداءً متساويًا على كل جهاز. بطاقة النموذج لا توفر قياسًا نستخدمه لوعد القارئ بعدد ثوانٍ معين.
الترخيص المفتوح يبدو كأنه يحسم كل شيء. ميّز بين ترخيص الأوزان وحقوق البيانات والمخرجات والأمثلة المصورة. وتقول البطاقة أيضًا إن التدريب والمخرجات لم يخضعا لترشيح أمان إضافي؛ لا تستخدمه لتصوير أشخاص أو أحداث حقيقية بما يوهم الناس أنها صور موثوقة. [1]
مصطلحات
المعاملات: القيم الرقمية التي يتعلمها النموذج؛ ليست عدد الصور التي يتذكرها ولا حجم ذاكرة التشغيل كله.
CPU وGPU: المعالج الرئيسي ومعالج الرسوميات. المثال هنا يستخدم CPU.
Diffusers وpipeline: مكتبة لتشغيل نماذج توليدية، وسلسلة المكونات التي تحول المدخل إلى ناتج.
VAE: مكوّن يتعامل مع تمثيل مضغوط للصورة ثم يحوله إلى بكسلات.
CFG: قوة توجيه التوليد بالوصف؛ رفعها ليس تحسينًا مضمونًا لكل جانب من النتيجة.
CLIP وFID: مقياسان للعلاقة بين النص والصورة ولإحصاءات مجموعة الصور، على الترتيب. لا يمثل أحدهما وحده جودة الصورة كلها.
GenEval: اختبار لتنفيذ متطلبات مرئية محددة، مثل عدد الأشياء ومواقعها.
Seed: قيمة تضبط البداية العشوائية للتوليد.
trust_remote_code: سماح بتشغيل شيفرة مخصصة من مصدر النموذج، وليس مجرد قبول ترخيص الأوزان.
ماذا بعد؟
اختبر ثلاثة أوصاف بسيطة، ثم اكتب لكل صورة ما طابق الطلب وما أخفق فيه. هذه تجربة تعليمية يمكنك فهم نتيجتها، بدل البدء بمقارنة ضخمة مع نماذج لم تشغّلها.
قيمة AuroraIMG-6M في صغر التجربة ووضوح حدودها. النتائج المنشورة تقيس صورًا بدقة 64×64، وتوضح البطاقة أن مقاييس FID وCLIP تكبّر الصور داخليًا؛ لذلك لا تستخدم أرقامها لترتيبه مباشرة أمام نماذج تنتج صورًا بدقة أعلى.
ولفهم تشغيل نماذج أخرى محليًا، اقرأ: ذكاء اصطناعي سريع على جهازنا: تجربتنا مع Qwen3.8-27B. وإذا كنت تريد واجهة تجمع نماذجك، اقرأ: اجمع نماذج الذكاء الاصطناعي في واجهة واحدة مع OpenWebUI.
المصادر ونسب الصور
مراجعة المصدر: 3d66743c3139d034b832a670d067221f5d544bbb. الغلاف تصميم تحريري أصلي يستند إلى معلومات البطاقة؛ وصورة النتيجة مقتطف من عينتين نشرهما المطوّر، مع إبقاء مظهرهما دون تحسين. لم نتعامل معهما بوصفهما تجربة من فريقنا، ولا نعيد نشر صور COCO الحقيقية أو بيانات التدريب.
[1] بطاقة AuroraIMG-6M: القدرات والقيود والنتائج والترخيص.
[2] تقرير المعاملات وتقييم مجموعة CC12M وإعدادات CFG.
[3] فهرس المكونات وإعداد tokenizer.
[5] وثائق Diffusers: المكونات المخصصة ومراجعة الشيفرة وتثبيت مصدرها.
[6] Hugging Face: مخاطر ملفات Pickle وحدود فحص الأمان.

لا تعليقات بعد. شارك سؤالك أو تجربتك مع هذا المحتوى.