 أنور پآي
قد تحمّل نموذج ذكاء اصطناعي على جهازك، ثم تكتشف أن الرد يتأخر أو أن اختيار النسخة المناسبة للذاكرة أصعب من التنزيل نفسه. يحاول Magnitude تسهيل هذه البداية: يفحص العتاد، يقترح نماذج مناسبة، ويشغّلها بمحرك يضبط أجزاء التنفيذ بحسب الجهاز.
Magnitude محرك لتشغيل النماذج، مع تطبيق لسطح المكتب؛ النموذج الذي يولّد الإجابة تختاره وتحمّله بصورة منفصلة. موضوعه هنا كيف تختار نموذجًا محليًا وتشغّله، لا تدريب نموذج جديد. [1]
تنبيه: هذه مراجعة للمستودع ووثائقه الرسمية، وليست اختبار أداء نفّذناه. الصورة والأرقام أدناه من المشروع، والخطوات مقترحة وفق الوثائق.
لمن هذا؟
لمن يريد تشغيل نموذج مفتوح الأوزان على الكمبيوتر، أي نموذج يمكن تنزيل أوزانه بدل الاعتماد على خدمة مستضافة لكل إجابة. يناسبك أيضًا إذا كنت تستخدم مساعدًا برمجيًا أو وكيلًا وتريد توصيله بنموذج محلي.
البداية المقترحة لا تتطلب كتابة كود: تثبيت التطبيق، تنزيل نموذج موصى به، ثم توصيل مساعد تدعمه Connections. وإذا كنت مرتاحًا مع الطرفية، ستجد طريقة لفحص الخدمة لاحقًا.
إذا كان جهازك محدود الذاكرة، ابدأ بنموذج صغير. المحرك قد يحسن التنفيذ، لكنه لا يلغي احتياجات النموذج للذاكرة ولا يضمن جودة العربية أو البرمجة في كل نموذج. [2][3]
ماذا ستحتاج؟
جهاز بنظام macOS أو Windows أو Linux، مع الإصدار والمعمارية المناسبين لحزمة التثبيت.
مساحة قرص لتنزيل النموذج، وذاكرة كافية أثناء تشغيله. حجم التنزيل وحده لا يحدد استهلاك الذاكرة.
اتصال إنترنت لتنزيل التطبيق والنموذج ومكوناته المطلوبة.
مساعد تدعمه Connections، أو تطبيق يمكنه الاتصال بواجهة متوافقة مع OpenAI إذا أردت إعداد الاتصال يدويًا.
وفق الوثائق، يستخدم Apple Silicon تسريع Metal، وتستخدم بطاقات NVIDIA المتوافقة CUDA على Linux وWindows. تستهدف إصدارات CUDA الحالية بطاقات Ampere وما بعدها، مع تعريف مناسب. بطاقات AMD والأجهزة المتوافقة الأخرى تستخدم Vulkan؛ المشروع لا يشحن حاليًا محرك ROCm. ويمكن التشغيل بالمعالج وحده، لكن حجم النموذج وسرعة الرد يظلان قيدين مهمين. [2]
على Linux، تتطلب الحزم glibc 2.35 أو أحدث، ولا تتوفر حزمة Alpine/musl في الوثائق الحالية. اختر ملف .deb أو .rpm أو حزمة Arch بحسب توزيعتك ومعمارية جهازك. [4]
التكلفة والخصوصية: ترخيص Magnitude هو Apache 2.0، وتراخيص النماذج مستقلة عنه. الاستدلال المحلي لا يحتاج دفعًا لكل رمز إلى مزود نموذج مستضاف، لكن العتاد والكهرباء والمساحة لها تكلفة. وتحقق من أدوات الوكيل واتصالاته: تشغيل النموذج محليًا لا يمنع الوكيل من إرسال بيانات عند استخدام البحث أو خدمات خارجية. إذا فعّلت الوصول من جهاز آخر، استخدم مفتاح الوصول وشبكة خاصة أو نفق SSH، ولا تعرض الخدمة للإنترنت بلا حماية. [1][3][7]
النتيجة النهائية (صورة)
النتيجة التي تستهدفها: نموذج مناسب لجهازك، مكتمل التنزيل، يستطيع المساعد إرسال طلب إليه والحصول على رد. وبعدها تراقب سرعة التوليد وتأخر بداية الإجابة بدل الحكم على الأداء من اسم النموذج وحده.
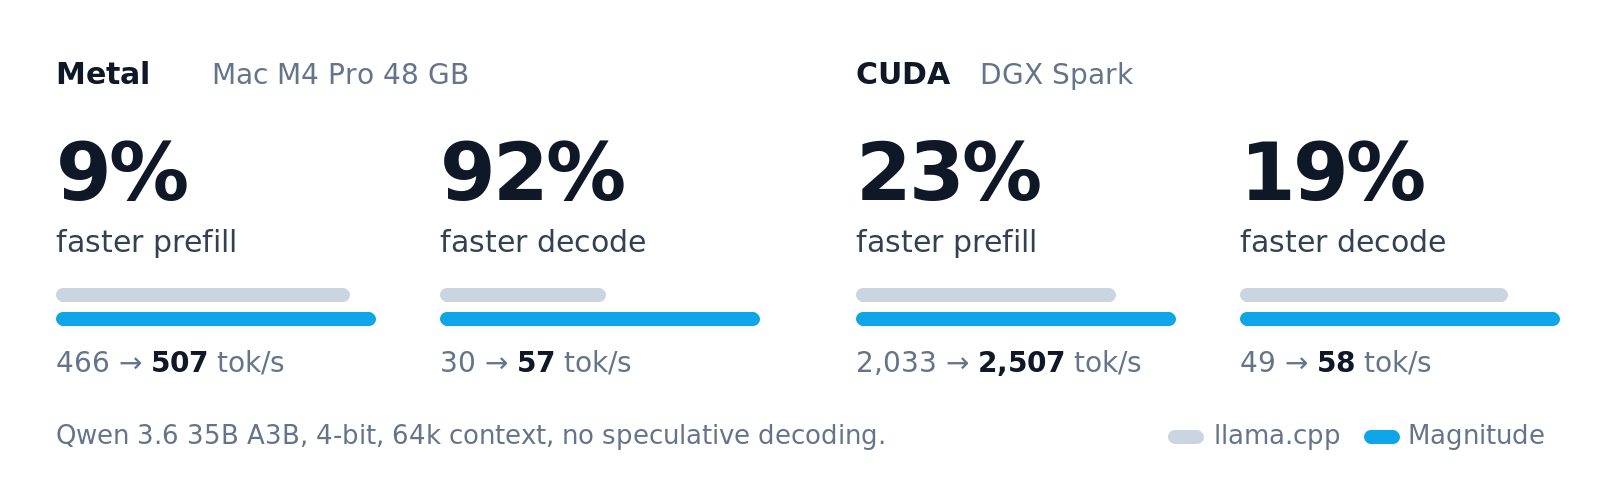
مصدر الصورة: الرسم الرسمي من مستودع Magnitude، حُوّل من SVG إلى PNG دون تغيير محتواه. يمثل نتائج المطورين للمقارنة مع llama.cpp، لا لقطة لتجربة محلية لدينا. [5]
يعرض الرسم نموذج Qwen 3.6 35B A3B بتكميم 4-bit، وسياق 64k، ودون التوليد التخميني الذي يستعين بنموذج مساعد لتسريع اقتراح الرموز. ويذكر:
على Mac M4 Pro بذاكرة 48 GB: تحسنًا معلنًا قدره 92% في توليد الإجابة، و9% في معالجة الطلب.
على DGX Spark باستخدام CUDA: تحسنًا معلنًا قدره 19% في توليد الإجابة، و23% في معالجة الطلب.
لهذا لا نقرأ عبارة «حتى ضعفي السرعة» في README على أنها وعد لكل جهاز. نتيجة CUDA هنا تختلف عن نتيجة Metal، وقد تتغير النتيجة مع النموذج والتكميم وطول المحادثة والعتاد. لم نُعد تنفيذ المقارنة أو ندقق منهجيتها كاملة. [1][5]
خطوات 1-2-3
1. ثبّت التطبيق واختر نموذجًا يناسب جهازك
نزّل Magnitude من صفحة التنزيل الرسمية، وثبّت الحزمة المناسبة لنظامك. التطبيق يتضمن أمر magnitude للطرفية؛ لا تحتاج تثبيت حزمة npm القديمة للحصول عليه. [1][8]
افتح Discover وابدأ بتوصية Balanced. إذا كانت الاستجابة أهم من حجم النموذج، جرّب توجيه الاختيار نحو Faster. راجع الذاكرة المتوقعة والقدرات، ثم اضغط Download وانتظر اكتمال التنزيل. [3][6]
اقرأ الأرقام في الواجهة بهذا المعنى:
Memory: تقدير ذاكرة التشغيل، وليس حجم الملف على القرص.
Speed: سرعة متوقعة على العتاد، وليست قياسًا لمهمتك الحالية.
Intelligence: مؤشر للمقارنة بين النماذج، لا نسبة إجابات صحيحة.
Capabilities: تحقق من دعم استخدام الأدوات أو الصور إذا كان مساعدك يحتاجهما.
وجود نموذج في Catalog لا يعني أنه يناسب جهازك. لا تبدأ بأكبر نموذج ظاهر؛ ابدأ بما تستطيع تحميله وتشغيله عمليًا. [3]
2. صِل النموذج بمساعدك
افتح Connections، واختر المساعد المثبّت لديك، ثم اضغط Connect. أعد فتح المساعد أو تحميل إعداداته حسب صفحة تكامله، واختر نموذج Magnitude الذي نزّلته. أبقِ Magnitude يعمل؛ فهو يحمّل النموذج عند الحاجة. [6]
إن كان تطبيقك يحتاج اتصالًا يدويًا بواجهة متوافقة مع OpenAI، فعنوان الأساس المحلي الموثّق هو:
http://127.0.0.1:10100/inference/v1
هذا عنوان أساسي لواجهة الاستدلال على الجهاز نفسه، وليس صفحة ويب للمحادثة. التطبيقات تضيف إليه مسار طلبها. لتعرف معرّفات النماذج المتاحة، افتح طرفية ونفّذ:
curl http://127.0.0.1:10100/inference/v1/models
على Windows PowerShell، استخدم curl.exe بدل curl. انسخ قيمة id الفعلية من الاستجابة عندما يطلب التطبيق اسم النموذج؛ الاسم المعروض في الواجهة ليس بديلًا مضمونًا عن المعرّف. [7][9]
إذا كان المساعد داخل حاوية أو WSL أو على جهاز آخر، لا تفترض أن 127.0.0.1 يشير إلى كمبيوتر Magnitude. اتبع وثائق الشبكة الخاصة بهذا السيناريو. [7]
3. اختبر ردًا قصيرًا، ثم راقب الأداء
ابدأ بطلب غير حساس، مثل:
اشرح الفرق بين ذاكرة RAM وذاكرة كرت الشاشة بالعربية، مع مثال قصير.
ظهور رد يؤكد مسار الاتصال لذلك الطلب، لكنه لا يثبت جودة كل مهام النموذج. افتح Usage وميّز بين Generation speed، سرعة توليد الرموز، وTime to first token، مدة الانتظار قبل ظهور أول رمز. قد يتأخر الطلب الأول لأن النموذج يحتاج التحميل. [3]
ولفحص الخدمة من الطرفية، بعد تثبيت التطبيق وتشغيله:
magnitude status
لا ننقل هنا مخرجات متخيلة لهذا الأمر. وفق الوثائق، يعرض حالة الخدمة والنموذج ويساعد على التمييز بين مشكلة بدء الخدمة ومشكلة تحميل النموذج. [8]
إذا أردت مقارنة بمحركك الحالي، استخدم النموذج والتكميم والطلب وطول السياق نفسيهما، وسجّل تفعيل التسريع التخميني من عدمه. قارن جودة الإجابة أيضًا؛ سرعة النص وحدها لا تكفي لاختيار نموذج للعمل.
مشاكل شائعة
الأمر magnitude غير موجود: افتح طرفية جديدة بعد التثبيت. على macOS افتح التطبيق مرة لتسجيل CLI، وعلى Linux استخدم الحزمة التي يوفرها المشروع لتوزيعتك. لا تعالج المشكلة بتثبيت حزمة npm القديمة. تحقق بعدها بـ magnitude --help. [8]
التنزيل اكتمل لكن النموذج لا يعمل: التنزيل يستهلك القرص، والتحميل يستهلك ذاكرة التشغيل. اقرأ الخطأ في Status أو My Models، وأغلق التطبيقات الثقيلة أو اختر نموذجًا أصغر. قد تزيد محادثة طويلة احتياج الذاكرة. [3][8]
المساعد لا يرى النموذج: تأكد من اكتمال التنزيل، ثم راجع Connections واستخدم Repair connection أو Refresh connection إذا ظهرا. أعد تشغيل المساعد واختَر النموذج، مع إبقاء Magnitude يعمل. [8]
الرد الأول بطيء: راقب وقت أول رمز منفصلًا عن سرعة التوليد. تحميل النموذج ومعالجة طلب طويل قد يطيلان البداية حتى إذا كان توليد النص سريعًا. قارن طلبًا لاحقًا قصيرًا قبل الاستنتاج. [3][8]
بطاقة الرسوم لا تتسارع كما توقعت: وجود بطاقة NVIDIA أو AMD وحده لا يثبت التوافق. راجع معلومات العتاد والنموذج والتعريف في التطبيق. ذاكرة النظام وذاكرة بطاقة الرسوم ليستا مجموعة واحدة يمكن جمعها حسابيًا لتحديد ما سيتسع للنموذج. [2]
الاتصال يفشل من حاوية أو جهاز آخر: وثائق الشبكة تفرّق بين خدمة متوقفة، ووصول شبكة معطّل، ومفتاح وصول مفقود. تأكد من عنوان الخادم ومسار الاتصال أولًا، ولا تعطّل المصادقة كحل. [7]
مصطلحات
الاستدلال: استخدام النموذج الجاهز لتوليد إجابة، بدل تدريبه.
محرك الاستدلال: البرنامج الذي يدير تنفيذ النموذج واستخدام الذاكرة والمعالج.
نواة التنفيذ، Kernel: جزء منخفض المستوى ينفّذ عملية حسابية على العتاد. يقول Magnitude إنه يترجم هذه الأجزاء ويضبطها على الجهاز.
التكميم، Quantization: تمثيل الأوزان بدقة أقل لتقليل الحجم والذاكرة، مع احتمال التأثير في الجودة.
السياق، Context: النص والمحادثة المتاحان للنموذج في الطلب؛ زيادتهما قد تزيد استهلاك الذاكرة.
Prefill: معالجة الطلب والسياق قبل توليد الإجابة.
Decode: توليد رموز الإجابة تباعًا؛ يُقاس غالبًا بالرموز في الثانية.
API: واجهة تتيح لمساعد أو تطبيق إرسال طلبات إلى المحرك.
ماذا بعد؟
اختر نموذجًا واحدًا من توصيات جهازك، وصِله بالمساعد، وجرّب الطلب العربي القصير أعلاه. دوّن جودة الإجابة ووقت البداية وسرعة التوليد. هذا سجل أولي أنفع من تنزيل عدة نماذج كبيرة دفعة واحدة.
إذا كنت تريد مثالًا مختلفًا لتشغيل نموذج محلي، اقرأ تجربتنا مع Qwen3.8-27B. هذه تجربة منفصلة؛ أرقامها ليست نتيجة استخدام Magnitude ولا دليلًا على أداء جهازك.
المصادر وحقوق الصور
[2] العتاد والقيود.
[4] التثبيت على Linux.
[6] البداية السريعة.
[8] حل المشكلات.

رُوجعت ملفات المستودع عند الإصدار المحدد في رابط README المثبّت. قد تتغير صفحات الوثائق العامة لاحقًا.
الرسم وشعار الغلاف من مشروع Magnitude، تحت ترخيص المستودع Apache 2.0. حُوّل الرسم إلى PNG، واستخدم الشعار في غلاف تحريري؛ لم تُنشأ لقطة واجهة وهمية. أُرفقت نسخة الترخيص مع حزمة المراجعة. حقوق العلامة التجارية محفوظة لأصحابها.
لا تعليقات بعد. شارك سؤالك أو تجربتك مع هذا المحتوى.