 أنور بآي
في أنور بآي، أنا وأنور نجرب النماذج المحلية باستمرار، ونعتمد عليها كثيرًا في عملنا. لا تقتصر تجاربنا على المحادثة: نعمل أيضًا على Fine-tuning، ونختبر نماذج تحويل النص إلى صوت TTS، والتعرف على الكلام STT، وتوليد الصور والفيديو. لذلك ننظر إلى النموذج من زاوية عملية: ماذا يستطيع إنجازه على الجهاز الذي نملكه؟
جهازي المنزلي يحتوي على بطاقتين RTX 5060 Ti، بذاكرة 16GB لكل بطاقة، أي مجموع 32GB VRAM. ومن بين النماذج التي جربتها، أصبح Qwen3.8-27B من أقوى اختياراتي عندما أبحث عن توازن بين سرعة التوليد والقدرة على معالجة المهام.
وصلت في المنزل إلى 187 token/s أثناء Decoding مع DFlash. كما كانت تجربتي جيدة في مهام إدارة الـHomelab: حاويات متعددة، وTalos وKubernetes Pods، وإدارة VPS، وS3، وCloudflare. لم أختبره في البرمجة بعد؛ هذا جزء أريد تجربته لاحقًا.
هذه نتائج وانطباعات يرويها أحمد، وليست اختبارات أعدنا تنفيذها لإعداد المقال. رقم السرعة ليس متوسطًا منشورًا بسجل قابل لإعادة الاختبار: لم نحدد بعد ملف Quantization وإصدار المحرك وطول السياق وعدد الطلبات المتزامنة. أما الأقسام التالية فتراجع مصادر النموذج والاختبارات الرسمية وتجارب المجتمع، مع الفصل بينها وبين تجربتنا.
ما النموذج الذي نتحدث عنه؟
هناك فرق بين النموذج الأصلي وبين الملف الذي تختار تشغيله. مستودع Qwen ينشر الأوزان الأصلية لـQwen3.8-27B بصيغة Transformers، بينما مستودع ggml-org يوفر تحويلات GGUF للاستخدام مع الأدوات المناسبة. بطاقة GGUF قصيرة نسبيًا وتربط النموذج الأصلي وملف DFlash المساعد.[1][2]
تصف Qwen النموذج بأنه Dense بحجم 27B، مبني على الأساس المعماري لـQwen3.5، مع بنية هجينة تجمع Gated DeltaNet وGated Attention. ظهور اسم qwen35 في معلومات GGUF لا يعني أننا راجعنا نموذج Qwen3.5 بدل Qwen3.8.[1][2]
هو نموذج يفهم النص والصور والفيديو، ويولد النص. لا يعني ذلك أنه نموذج TTS أو STT أو مولد صور وفيديو؛ تلك تجارب منفصلة لدينا. تشغيل المدخلات المرئية محليًا يحتاج أيضًا إلى ملفات ودعم في المحرك، وليس مجرد تحميل ملف اللغة الرئيسي.[2][5]
تذكر بطاقة النموذج سياقًا أصليًا يصل إلى 262,144 token، وإمكانية تمديده إلى مليون عبر إعدادات مناسبة مثل YaRN. هذه قدرة موثقة، وليست وعدًا بأن جهازًا منزليًا يستطيع استخدامها كاملة مع أي Quantization أو عدد جلسات. وتحذر البطاقة من أن التمديد الثابت قد يؤثر على أداء النصوص الأقصر.[2]
ماذا تقول الاختبارات الرسمية؟
اخترنا نتائج من جدول Qwen3.8-27B نفسه، لا من صورة إطلاق Qwen3.8-Max الأكبر. الأسماء متشابهة، لكن نقل نتائج Max إلى نموذج 27B سيعطي انطباعًا خاطئًا.[2][4]
من النتائج التي ينشرها فريق Qwen:[2]
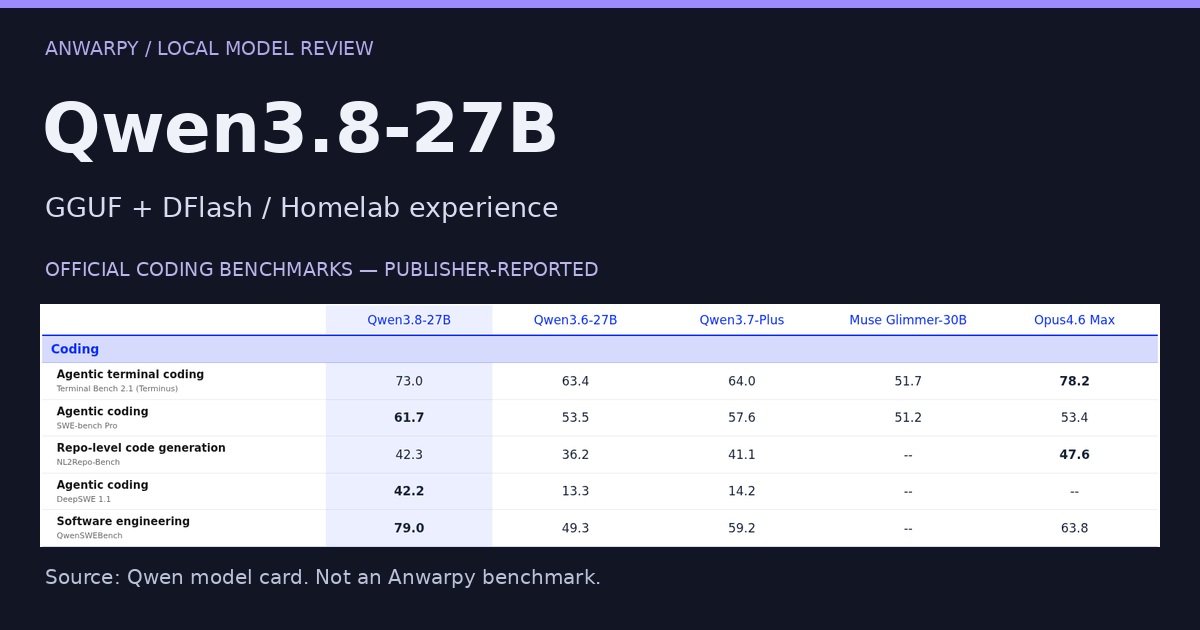
Terminal Bench 2.1: 73.0 مقابل 63.4 لـQwen3.6-27B، في مهام برمجة باستخدام الطرفية.
SWE-bench Pro: 61.7 مقابل 53.5 لـQwen3.6-27B.
LiveCodeBench v6: 90.3 مقابل 83.9 لـQwen3.6-27B.
IFBench: 79.5 مقابل 69.1، لاتباع التعليمات.
GPQA Diamond: 89.2 مقابل 87.8، للاستدلال العلمي.
CoWorkBench: 70.7 مقابل 61.0، وهو اختبار داخلي لدى الفريق لمهام عمل طويلة.
وفي القدرات متعددة الوسائط، ينشر الفريق 84.3 في OSWorld-Verified، و64.8 في WebArena-Verified، و91.1 في OmniDocBench 1.5. هذه نتائج تقييم ضمن Harnesses وإعدادات محددة، وليست ضمانًا لنجاح كل مهمة سطح مكتب أو متصفح محلي.[2]
ينبغي قراءة ملاحظات الجدول أيضًا. يذكر الفريق استخدام Claude Code Harness في عدة اختبارات، وسياق 256K، وإعدادات Sampling محددة؛ كما يصرح بتصحيح بعض المهام أو بياناتها وإعادة تقييم المقارنات. وبعض الاختبارات، مثل QwenSWEBench وCoWorkBench، داخلية. لذلك نعامل النتائج كأدلة ينشرها المطور، لا كإعادة اختبار مستقلة لكل نموذج أو لكل GGUF مضغوط.[2]
الغلاف يتضمن مقتطفًا من جدول البرمجة الرسمي، وأرفقنا مع مسودة المقال صورة الجدول النصي الكامل. الصورة تمثيل للجدول المنشور، مع عنوان ونسبة المصدر، وليست رسمًا لنتائج جهازنا أو لسرعة 187 token/s.
هل هو «أفضل نموذج محلي»؟
بالنسبة إليّ، هو من أفضل ما جربت لتحقيق التوازن الذي أحتاجه. هذا رأي عملي له نطاق، وليس ترتيبًا مطلقًا لكل نموذج ولكل جهاز.
يوفر Artificial Analysis زاوية مستقلة: تعرض صفحته وضع xhigh بنتيجة 34 في Intelligence Index، وتضعه ضمن النماذج المتقدمة في فئته. والمقارنة في تلك الصفحة محددة بفئة النماذج المفتوحة ذات الحجم المشابه، لا بكل النماذج بلا استثناء.[5]
أما سرعة 46.1 token/s المذكورة هناك فمرتبطة بواجهة Alibaba API التي تقيسها الجهة، وليست سرعة متوقعة على RTX 5060 Ti. لا يصح مقارنتها مباشرة برقمنا المحلي أو استنتاج أن جهازنا يتفوق على الخدمة دون اختبار موحد.[5]
GGUF: أي الملفات هي النموذج الكامل؟
في Revision الذي راجعناه من مستودع ggml-org، أحجام ملفات اللغة الرئيسية على القرص هي تقريبًا:[10]
Qwen3.8-27B-Q4_K_M.gguf: 18.97GB، أو 17.67GiB.
Qwen3.8-27B-Q8_0.gguf: 28.60GB، أو 26.63GiB.
Qwen3.8-27B-BF16.gguf: 53.81GB، أو 50.11GiB.
GB وGiB وحدتان مختلفتان؛ وهذه أحجام ملفات، وليست مجموع ذاكرة التشغيل. تحتاج إلى مساحة إضافية للـKV Cache وBuffers، وربما Drafter وVision Projector. لا تختَر ملفًا لأن حجمه قريب من مجموع VRAM ثم تفترض أن كل الباقي مجاني.[7][8][10]
يوجد في المستودع أيضًا ملف DFlash بحجم يقارب 1.09GB وملف MTP بحجم يقارب 1.68GB عند ضغط Q4_0. هذه ملفات مساعدة؛ ليست نسخة كاملة من نموذج 27B يمكن تشغيلها وحدها بدل الأوزان الرئيسية. بطاقة DFlash2 تصرح بأنه Drafter يعمل داخل خادم Speculative Decoding ويقترح Tokens يتحقق منها النموذج الهدف.[7][10]
ماذا يعني وجود بطاقتين بذاكرة 16GB؟
مجموع الذاكرة في جهازي 32GB، لكن البطاقتين لا تتحولان إلى بطاقة واحدة بذاكرة موحدة. يجب أن يدعم المحرك توزيع الحمل، وتتأثر النتيجة بطريقة التقسيم والذاكرة المتاحة على كل بطاقة ومسارات الاتصال.
وهناك تجربة مجتمعية قريبة من عتادي: يصف OVERBRING جهازًا ببطاقتين RTX 5060 Ti 16GB مع إعداد Layer Splitting وMTP، وQuantization مختلف، وطوبولوجيا PCIe محددة. يذكر سرعة توليد قصوى تقارب 45 token/s في تجربته. هذه ليست نتيجة تناقض رقمنا؛ إعداداته ليست إعدادات DFlash التي استخدمتها، ولا نملك مقارنة موحدة بين الجهازين.[8]
كذلك لا أوصي افتراضيًا بـQ8_0 على مجموع 32GB لمجرد أن ملفه 28.6GB. قد تصبح الذاكرة المتبقية ضيقة عند إضافة السياق أو الملف المساعد، ويجب قياس الاستخدام الفعلي. Q4_K_M نقطة تجربة معقولة لهذا المستودع، لا حكمًا بأنه الأفضل لكل مهمة.[10]
نسخة أقل من 8GB: المقصود Underdog Saluki
جربت أيضًا نسخة صغيرة، وهي Underdog-Saluki-27B-1.0 من ConwayResearch. هذه نسخة مشتقة من Qwen3.8-27B، مبنية أيضًا على عمل ISTA-DASLab، وليست ملف Q4_K_M الموجود في ggml-org. اسم ملفها Underdog-Saluki-27B-1.0-IQ2-mix.gguf، وتذكر البطاقة حجمًا يقارب 7.89GB.[6]
لكن «ملف أقل من 8GB» لا يعني تلقائيًا «كل التشغيل داخل 8GB VRAM». هناك ذاكرة إضافية للسياق والمحرك، ومع الصور تضاف ملفات Vision بحجم آخر. لم يحدد وصف تجربتي هنا مقدار CPU Offload أو RAM أو السياق المستخدم، لذلك لا نقدم وصفة مضمونة لبطاقة 8GB.[6]
ينشر أصحاب Saluki نتائج تخص نسختهم، منها 88 مهمة ناجحة من 120 في اختبار Tool Calling مقابل 84 للنموذج الكامل وفق إعداداتهم. هذه ليست نسبة 88%، وليست نتيجة جدول Qwen الرسمي. كما يوضحون أن بعض المقارنات العامة جاءت من Harness مختلف، وأن حجم الاختبار محدود.[6]
وتذكر البطاقة تنازلات، منها انخفاض الأداء في بعض مسائل الرياضيات، وأخطاء تنسيق في بعض استدعاءات الأدوات المتوازية، واستدلال طويل عند تفعيل Thinking. لذلك اختبر النسخة الصغيرة على نوع المهمة الذي يهمك؛ لا تفترض أن ضغط الملف بهذا القدر يحافظ على كل القدرات بالتساوي.[6]
لماذا DFlash مهم في تجربتنا؟
أكدت أن رقم 187 token/s الذي رأيته كان أثناء Decoding مع DFlash، وليس سرعة معالجة الـPrompt. الفرق مهم: معالجة المدخلات وتوليد مخرجات جديدة مرحلتان مختلفتان.
في Speculative Decoding، يقترح مكون أسرع عدة Tokens، ثم يتحقق منها النموذج الهدف. تصف بطاقة DFlash2 آلية اقتراح كتلة Tokens بصورة متوازية، وتذكر أن التنفيذ الصحيح يحافظ على خرج Greedy أو توزيع Sampling للنموذج الهدف. هذا وصف للآلية، وليس إثباتًا لكل إصدار أو إعداد محلي.[7]
ولا يعني استخدامي «DFlash» أنني حددت هنا ملف DFlash2 بعينه أو إصداره؛ هذه تفاصيل ينبغي إضافتها لسجل مقارنة لاحق. كما لا نقول إن DFlash وحده يمنح كل جهاز 187 token/s.
من تجارب المجتمع، يعرض مستودع lukaLLM دراسة لـQwen3.8-27B مع DFlash2، لكنه يستخدم RTX PRO 6000 Blackwell واحدة، لا بطاقتيّ. كما يفصل دراسة Qwen3.8 عن دراسة أقدم لـQwen3.6، ويبين أن نتائجه المعلنة تتعلق بالسرعة وأنها قِيست على Build معين. لا ننقلها كاختبار جودة برمجية، ولا نستخدم صورة Docker أحدث لنسب نتائج لم تُقَس عليها.[9]
الاستفادة العملية هي أن التسريع يحتاج إلى ملف مساعد متوافق ومحرك يدعم المسار وميزانية ذاكرة مناسبة. وقد يختلف أثره باختلاف المهمة ومعدل قبول الاقتراحات وعدد الطلبات المتزامنة.[7]
سرعة Tokens ليست زمن إنجاز المهمة
187 token/s رقم يهمني لأنه يجعل التفاعل المحلي أكثر راحة. لكنه لا يجيب وحده عن الأسئلة التالية: كم انتظرت قبل أول Token؟ كم استغرق التفكير؟ كم مرة أخطأ النموذج أو احتاج إلى إعادة محاولة؟ وهل أنجز المهمة المطلوبة؟
تذكر Qwen أن Thinking مفعّل افتراضيًا، وأن reasoning_effort يدعم xhigh وmedium وlow. وتوضح أن تقليل التفكير قد يسرّع الدور الواحد، لكنه قد يزيد الفشل والمحاولات في مهمة متعددة الخطوات، فيرتفع زمن الإنجاز الكلي.[2]
هنا تختلف تجارب المجتمع. يصف Simon Willison تفكيرًا مفرطًا في طلبات بسيطة، ويوصي بالبدء بمستوى أقل أو دون Thinking لمثلها. أما OVERBRING فيفضل التفكير الأعمق في بعض مهام البرمجة التي يريد إنهاءها دون تدخل متكرر. هذان استخدامان مختلفان، وليس هناك إعداد واحد يستنتج من اسم النموذج وحده.[3][8]
لذلك أبدأ بطلب واضح ومحدود، وأضبط مستوى التفكير بحسب المهمة ودعم المحرك. أمر قراءة حالة خدمة بسيط لا يحتاج بالضرورة إلى الإعداد نفسه الذي أستخدمه لفهم مشكلة ممتدة عبر Kubernetes وخدمات خارجية.
خطوات بداية محلية دون ادعاء أنها إعدادات جهازي
تورد بطاقة ggml-org أمرًا لتشغيل النموذج عبر llama، ويظهر تحديد Q4_K_M كذلك في تجربة Simon:[1][3]
llama serve -hf ggml-org/Qwen3.8-27B-GGUF:Q4_K_M
هذا أمر موثق لبيئة لديها أداة llama المتوافقة، وليس أمر تثبيت، وليس إعداد الـDFlash الذي أنتج 187 token/s عندي. قد ينزّل أوزانًا كبيرة ويبدأ خدمة محلية؛ راجع الإصدار والإعدادات قبل تشغيله.
ابدأ بالنموذج الهدف وحده، بسياق يناسب المهمة والذاكرة. تحقق من سرعة التوليد واستهلاك الذاكرة وصحة Tool Calls، ثم جرّب التسريع كمتغير مستقل. لا تغيّر Quantization والسياق والتفكير وDrafter كلها في وقت واحد وتستنتج سبب التحسن.
توصيات Qwen المنشورة لـThinking تشمل temperature=1.0 وtop_p=0.95 وtop_k=20. أما Non-thinking فله إعدادات مختلفة، منها temperature=0.7 وtop_p=0.8. ليست هذه وصفة Saluki نفسها؛ اتبع بطاقة النسخة التي تشغلها، وتأكد أن محركك يدعم المعاملات فعلًا.[2][6]
مهام الـHomelab: القدرة تحتاج إلى حدود تشغيل
ما أعجبني حتى الآن هو معالجة مهامي المتعلقة بالحاويات وTalos وKubernetes وVPS وS3 وCloudflare. هذا وصف تجربتي، وليس إعلانًا أن كل تغيير اقترحه صحيح أو أن النموذج مؤهل لإدارة إنتاج دون رقابة.
إذا ربطته بوكيل أدوات، افصل التحليل عن التنفيذ. ابدأ بقراءة الحالة والسجلات، واطلب تحديد المشكلة والأدلة وخطة التغيير. اجعل حذف الموارد وتغيير سياسات الوصول وتعديل DNS أو التخزين يحتاج إلى موافقة، ثم اقرأ الحالة الفعلية بعد الإجراء بدل الاكتفاء برسالة نجاح.
التشغيل المحلي قد يقلل إرسال محتوى العمل إلى مزود نموذج خارجي، لكنه لا يمنع الوكيل من الاتصال بـCloudflare أو S3 أو VPS عندما تمنحه أدواتها. ولا يبرر إدخال مفاتيح الوصول في محادثات أو نشر سجلات Homelab حساسة.
ما الذي سنختبره لاحقًا؟
لم أختبر البرمجة بعد، ولذلك لا أحوّل SWE-bench أو تجارب الآخرين إلى شهادة أداء من عندي. أريد اختبار مهمة برمجية لها نتائج واضحة: إصلاح خلل، واختبارات قبل التعديل وبعده، ومراجعة التغييرات، مع تسجيل المحاولات والزمن.
وللمقارنة المحلية القادمة، سأحتاج إلى توثيق اسم GGUF وRevision، ومحرك التشغيل وإصداره، وملف DFlash، وتوزيع البطاقتين، وحجم السياق وKV Cache، وإعداد التفكير وSampling. وسأفصل بين زمن معالجة المدخلات وسرعة Decoding وزمن اكتمال المهمة.
الخلاصة عندي: Qwen3.8-27B يستحق التجربة الجادة على جهاز محلي مناسب. رأيي الإيجابي يأتي من الاستخدام الذي وصفته، والاختبارات الرسمية تعطي سببًا إضافيًا للاهتمام، لكن أفضل اختيار لك يحدده عتادك ونوع مهامك والنسخة التي تشغلها.
المشروع الأصلي ونسخة GGUF وSaluki تحمل تراخيص Apache 2.0 بحسب بطاقاتها. والغلاف يحتوي على مقتطف من جدول Qwen الرسمي مع نسبته إلى الفريق؛ لا يمثل نتائج مستقلة أو قياس جهاز الكاتب.[1][2][6]
Sources
[1] https://huggingface.co/ggml-org/Qwen3.8-27B-GGUF
[2] https://huggingface.co/Qwen/Qwen3.8-27B
[3] https://simonwillison.net/2026/Aug/16/qwen-38-27b
[4] https://qwen.ai/blog?id=qwen3.8
[5] https://artificialanalysis.ai/models/qwen3-8-27b
[6] https://huggingface.co/ConwayResearch/Underdog-Saluki-27B-1.0
[7] https://huggingface.co/incoai/Qwen3.8-27B-DFlash2
[8] https://overbring.com/blog/2026-08-17-qwen3-8-27b-wall-clock
[9] https://github.com/lukaLLM/DFlash2_Qwen3.8_3.6_27B_LlamaCPP
[10] https://huggingface.co/ggml-org/Qwen3.8-27B-GGUF/tree/71bc7b627595dc8a91039addd9c791ae548d6747
لا تعليقات بعد. شارك سؤالك أو تجربتك مع هذا الدليل.